Publicación del proyecto · IEEE Internet of Things Journal
Resumen
MARLTC propone un mecanismo de aprendizaje por refuerzo multiagente para el Adaptive Data Rate de LoRaWAN, seleccionando de forma conjunta el factor de expansión y la potencia de transmisión en despliegues densos y con interferencia.
Indicadores bibliométricos
- Área JCR
- Computer Science, Information Systems
- Año JCR
- 2025
- Consulta Scholar
- 26 octubre 2026
Contribución principal
El artículo modela el control de transmisión en LoRaWAN como un juego de Markov cooperativo y utiliza entrenamiento centralizado con ejecución descentralizada. Las políticas preentrenadas se ejecutan en los dispositivos finales e infieren parámetros de transmisión a partir de observaciones locales realistas, como el historial reciente de transmisión, la relación señal-ruido y la distribución de factores de expansión.
Resultados y alcance
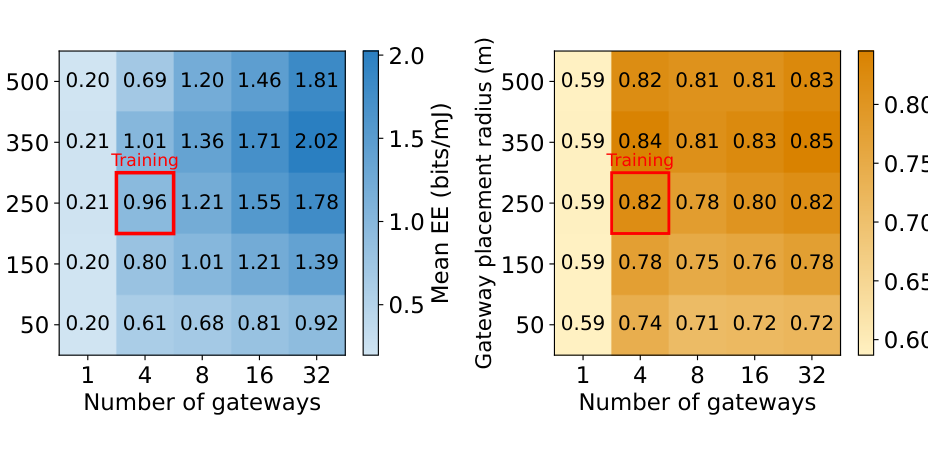
Las simulaciones muestran que la coordinación multiagente puede reducir interferencias y adaptar las transmisiones al estado local de la red sin depender de un controlador central con información completa. La ganancia depende de la densidad, la carga y la estabilidad del aprendizaje, por lo que el trabajo delimita también los requisitos para trasladar MARLTC a despliegues LoRaWAN reales.
Relación con BoND1
El trabajo está alineado de forma directa con BoND1 porque aborda conectividad IoT no celular escalable y fiable. Al reducir interferencia co-canal y controlar de forma conjunta el factor de expansión y la potencia de transmisión, MARLTC refuerza la operación de LoRaWAN en despliegues densos orientados a B6G, donde son críticos la fiabilidad, la eficiencia energética y la viabilidad en dispositivos embebidos.
Project publication · IEEE Internet of Things Journal
Summary
MARLTC proposes a multi-agent reinforcement-learning mechanism for LoRaWAN Adaptive Data Rate, jointly selecting spreading factor and transmission power in dense, interference-prone deployments.
Main contribution
The paper models LoRaWAN transmission control as a cooperative Markov game and uses centralized training with decentralized execution. Pre-trained policies run at end devices and infer transmission parameters from realistic local observations such as recent transmission history, signal-to-noise ratios and spreading-factor distribution.
Results and scope
Simulations show that multi-agent coordination can reduce interference and adapt transmissions to local network state without a central controller holding complete information. Gains depend on density, load and learning stability, so the work also defines the requirements for transferring MARLTC to real LoRaWAN deployments.
Link with BoND1
The work is directly aligned with BoND1 because it targets scalable and reliable non-cellular IoT connectivity. By reducing co-channel interference and jointly controlling spreading factor and transmission power, MARLTC strengthens LoRaWAN operation in dense B6G-oriented deployments where reliability, energy efficiency and embedded feasibility are critical.